内存管理概念
页式虚拟存储的细节都在 组成原理章节,对于本节,重点掌握 动态分区分配算法 以及 几种内存管理方式(页式、段式、段页式)的概念和特点。
内存管理
基础概念
虚拟地址(VA, Virtual Address)由指令中的 地址字段 给出,进程看到的都是虚拟地址。物理地址是内存单元在 实际内存硬件 中的真实位置。
地址翻译指的是在程序执行的过程中 将虚拟地址翻译为物理地址,地址变换由 内存管理单元(MMU, Memory Management Unit) 在硬件中完成,速度非常快。
- 内存共享
共享内存(Shared Memory)是多个 进程 共享的 内存区域。它是最快的 IPC(进程间通信)机制之一,因为进程直接读写内存,无需进入内核态。但是,因为多个进程可以同时访问这些内存,所以可能需要某种 同步机制(如信号量)来防止竞态条件。
- 内存保护
内存保护是现代操作系统中的一个 核心功能,用于防止一个进程访问另一个进程的 内存空间。这不仅保障了系统的稳定性,而且提高了安全性,因为它可以防止恶意软件损害其他进程或篡改其数据。
可以通过如下机制实现内存保护机制:
- 分段 与 分页:
- 分段:内存被划分为不同的 段,每个段都有其起始地址和长度。段常常用于表示高级的数据结构,如函数或对象。
- 分页:虚拟地址空间被划分为固定大小的 页,物理内存被划分为同样大小的 页框,例如 4 KiB。操作系统为每个进程维护 页表,把虚拟页映射到物理页框。
- 访问权限:每个段或页面都有与之相关的访问权限。例如,一个页面可能被标记为只读,这意味着任何尝试写入该页面的操作都会引发一个异常。
- 隔离:由于每个进程都有其独立的地址空间,所以一个进程不能直接访问另一个进程的内存。这为每个进程提供了一种形式的 隔离,确保了一个出错的进程不会影响其他进程。
管理方式分类
在现代操作系统中,内存管理方式 大体可以归纳为两类:连续分配 和 离散分配。所谓 连续分配,是指操作系统为进程分配一整段连续的内存区域。这种方式实现简单、开销较小,但灵活性不足。典型的连续分配方式包括三种:单一连续分配、固定分区分配 以及 动态分区分配。
相比之下,离散分配 方式允许进程占用的内存空间是 不连续的,这使得内存利用率和管理灵活性显著提高。典型的离散分配方式也包含三种:页式、段式、段页式。
后文会具体介绍这几种内存管理方式的细节。
连续分配管理方式
单一连续分配
内存在此方式下分为 系统区 和 用户区,系统区仅供操作系统使用。在 408 教材的典型示意中,系统区通常位于内存低地址部分,用户区占据其余连续空间;实际布局可由具体系统决定,判断题应以题设地址布局为准。在用户区内存中仅有一道用户程序,即整个用户区由该程序独占。
这种方式的优点是 简单、无外部碎片,也无需做用户进程之间的保护;但仍需用界限寄存器等机制防止用户程序越界访问操作系统区。缺点是只能用于 单用户、单任务 的操作系统中,存储器的利用率极低。
固定分区分配
固定分区分配是最简单的一种 多道程序存储管理 方式,它将用户内存空间划分为若干 固定大小的区域,每个分区只装入一道作业。当有空闲分区时,便可再从外存的后备作业队列中选择适当大小的作业装入该内存,如此循环。
为了方便内存分配,通常将分区按大小排队,并为之建立一张 分区说明表,其中各表项包含每个分区的起始地址、大小和状态。当有用户程序需要装入时,便检索该表,以找到合适的分区基于分配并将其状态设置为“已分配”;未找到合适分区时,则拒绝为给程序分配内存。
动态分区分配
在 固定分区分配 中,内存被预先划分为若干大小固定的区域。 这种方式实现简单,但也带来了一个明显问题:分区大小是静态的,而作业大小是动态的。
为了解决固定分区“尺寸僵化、内存利用率低”的问题,操作系统引入了 动态分区分配。
动态分区分配的基本思想是: 不再事先划分固定大小的分区,而是将整个用户内存空间视为一块 连续的可分配区域,在程序装入时才根据其实际需要动态地划分内存。
当进程请求内存时,操作系统从当前的空闲内存中划出一块连续区域分配给该进程; 当进程结束或释放内存时,该区域重新成为空闲内存,可供后续进程再次使用。
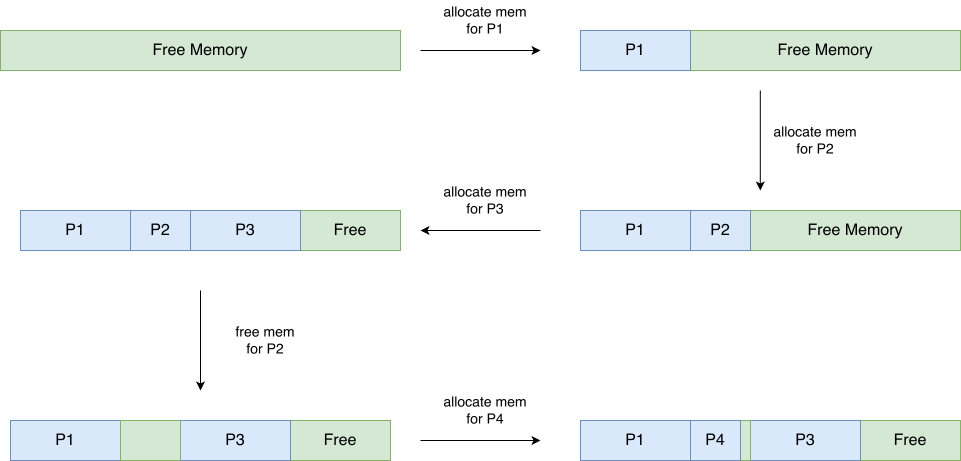
通过这种 动态、按需分配 的方式,内存从逻辑上被划分为两类区域:
- 已分配区:正在被内核或进程占用的内存
- 空闲区:尚未分配、可供后续进程使用的内存
如下图所示,其中 内核内存(kernel memory) 和 进程内存(process memory) 属于已分配区域,其余部分为系统当前的空闲内存。

为了管理这些不断变化的空闲区域,操作系统通常维护一张 空闲分区表(或空闲链表),用于记录每一块空闲内存的:
- 起始地址
- 大小
示意如下:
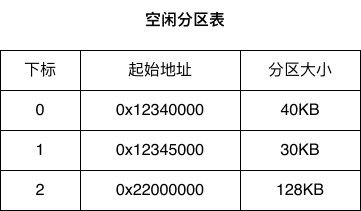
当进程申请内存时,操作系统会遍历 空闲分区表,按照预定的 适应算法(如首次适应、最佳适应等),从中选择一块满足需求的空闲区域,并完成内存分配。
不同适应算法的选择,会直接影响系统中 外部碎片 的产生情况,这一点将在后续章节中详细讨论。
内存碎片
动态分区分配相比固定分区分配,提高了内存使用率,但是仍然无法避免内存碎片的问题,下图以一个实例说明了在动态分区分配过程中内存碎片产生的过程:
由于各进程所需的内存大小各不相同,在进行内存分配时经常会在已分配的块之间留下 内存碎片。
动态分区产生的是 外部碎片:空闲总量可能足够,但被已分配区分隔成多个不连续小块,无法满足某次连续空间请求。固定分区和分页还可能产生 内部碎片,即已经分给进程、却因分配单位大于实际需求而未被利用的空间。
适应算法
内存空间中的空闲区域可能大小不一,且分布在内存中不同的位置,操作系统使用 空闲块表 来记录这些空闲区域的信息。
当进程申请一块新的内存时,必须从已有的空闲空间中选出一块分配给进程。动态分区的分配策略主要包含四种算法:首次适应(First Fit)、临近适应(Next Fit)、最佳适应(Best Fit)、最坏适应(Worst Fit)。
- First Fit(首次适应):从空闲块表头开始,找到第一个足够大的空闲块。
- Next Fit(邻近适应):从上次查找结束位置继续循环查找,选择遇到的第一个足够大的空闲块。
- Best Fit(最佳适应):遍历全部候选块,选择能满足请求的最小空闲块。
- Worst Fit(最坏适应):遍历全部候选块,选择最大的空闲块。
注意
临近适应中的 next 究竟如何理解
“next” 指 从上一次查找结束的位置继续循环查找,而不是每次都从空闲表表头重新开始。若上次在空闲块 B2 中切出一部分,游标究竟落在 B2 的剩余部分还是下一个空闲块 B3,要由题目给出的链表组织和游标定义判断,不能一概断言“必定跳过 B2”。
例如,空闲块按 B1、B2、B3 排列,上次查找在 B2 结束:若游标指向分割后 B2 的剩余空闲部分,就先检查该剩余部分;若题设规定游标移动到下一空闲块,则从 B3 开始。两种写法的共同点都是从上次结束处向后循环,而非回到 B1。
适应算法中的利用率计算
假设进程申请的内存大小为 P,空闲块大小为 F,则利用率为:
举个实例例子,假设空闲块序列 [8, 22, 20, 14, 10, 24],请求大小 P = 16。则四种分配算法会得到不同的结果:
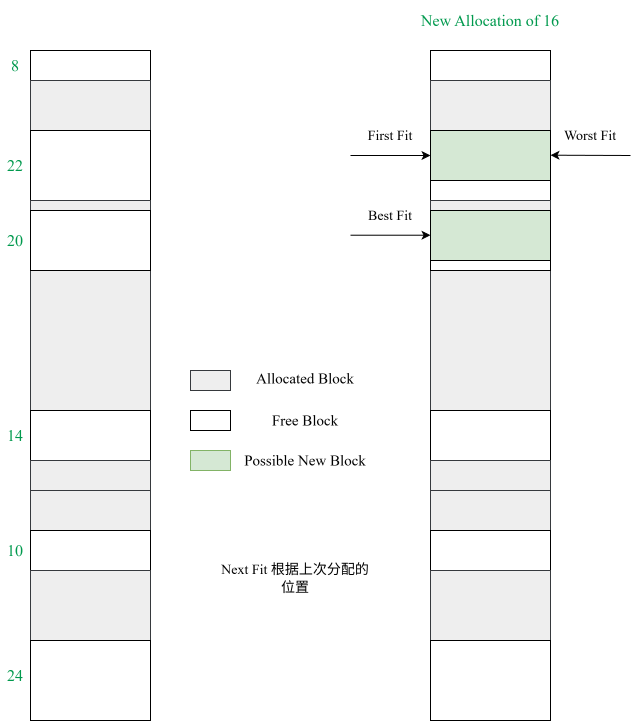
四种适应算法在该例子的对比如下表所示:
| 算法 | 查找方式 | 本例选择结果 |
|---|---|---|
| First Fit | 从表头找到第一个 的分区 | 22(第一个不小于 16 的块) |
| Next Fit | 从上次查找结束位置继续循环查找 | 取决于游标:在 8 后选 22;在 22 后选 20;在 20 后继续可选 24 |
| Best Fit | 选择满足 的最小分区 | 20, |
| Worst Fit | 选择满足 的最大分区 | 24, |
内存回收过程
当对 动态内存 进行回收时,需要检查是否可以有相邻 空闲块 合并,如果可以合并的话,合并后需要更新起始地址和大小。
如果没有相邻的空闲块需要合并,直接将释放的内存块作为 独立空闲块 插入空闲块表。
堆内存分配
动态分区分配最初用于操作系统在物理内存中为进程分配连续空间;随着虚拟内存的引入,进程不再需要连续的物理内存,该机制在 OS 层面被分页取代;但其在连续地址空间中按需划分和回收内存的思想,被继承并演化为进程堆内存的分配机制。
- 早期 OS(无虚拟内存) 动态分区用于在物理内存中为进程分配连续空间。
- 引入虚拟内存 分页机制消除了进程对连续物理内存的需求,OS 层面的动态分区逐渐退出。
- 思想下沉到用户态 动态划分、回收连续空间的思想,被用于管理进程的堆内存,形成现代内存分配器。
参考 进程内存空间,当一个进程使用操作系统提供的 malloc 接口时,它实际上是在向进程的堆(heap)区域请求一块连续可用的虚拟地址空间,当进程使用 free 接口时,实际上是在堆上释放刚刚申请的动态空间。操作系统或运行时库会负责管理堆空间,其底层机制正是动态分区分配思想的延续。
具体来说,堆内存管理器维护着一个空闲内存块的列表(或类似数据结构),当进程申请内存时,管理器会根据 适应算法 寻找足够大的空闲块,将其一部分分配给请求,剩余部分可能仍作为空闲块保留。当进程释放内存时,该内存块会被回收并合并相邻的空闲块,以减少碎片。
伙伴算法
伙伴算法(Buddy Algorithm)将内存分为大小为 的块(例如 1 KB、2 KB、4 KB、8 KB)。当需要分配内存时,算法寻找合适的块;如果没有,就将更大的块一分为二,直到满足需求。释放内存时,算法尝试将空闲伙伴块合并为更大的块。
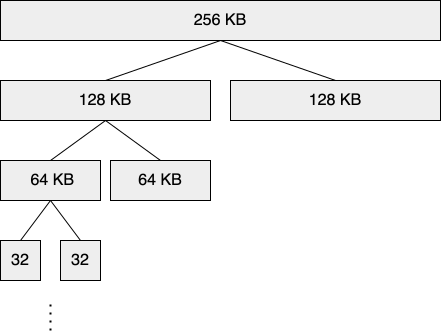
内存分配过程
- 假设需要分配大小为 的内存,算法找到满足 的最小 块。
- 如果有,直接分配该块。
- 如果没有,查找更大一级的 空闲块,将其一分为二,生成两个 的伙伴块:
- 一个用于分配。
- 另一个加入 的空闲链表。
- 如果 也没有空闲块,继续向上查找,直到找到合适大小的块或失败。 分配后更新空闲链表。
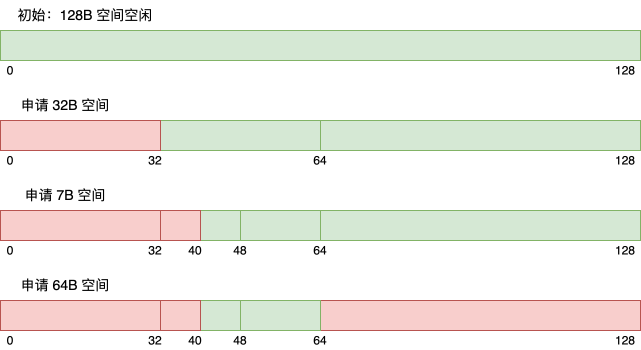
下图包含一个使用伙伴算法的 内存分配实例:
内存释放过程
- 释放一块内存时,检查其“伙伴”块是否也空闲:
- 伙伴块是指与当前块大小相同、地址相邻、且由同一父块分割而来的块。
- 例如,地址为 的 块,其伙伴地址可由对齐后的地址关系确定。
- 如果伙伴块空闲,合并为一个 的块,并加入更高一级的空闲链表。
- 重复检查合并,直到无法合并(伙伴不空闲或达到最大块大小)。
提示
联想一下 2048 小游戏,伙伴算法的内存释放过程与之十分类似。
伙伴关系
伙伴块的地址满足特定关系。若内存起始地址为 0、块大小为 ,则地址 的伙伴地址为 (按位异或)。这个公式成立的前提是块按 对齐,并且 表示块起始地址。
例如,块大小为 且块起始地址为 16 时,其伙伴地址为 。
离散分配管理方式
页式管理
页式管理的细节详见 组成原理中的对应章,这里仅给出基本的思想以与 段式管理 和 段页式管理 进行对比。
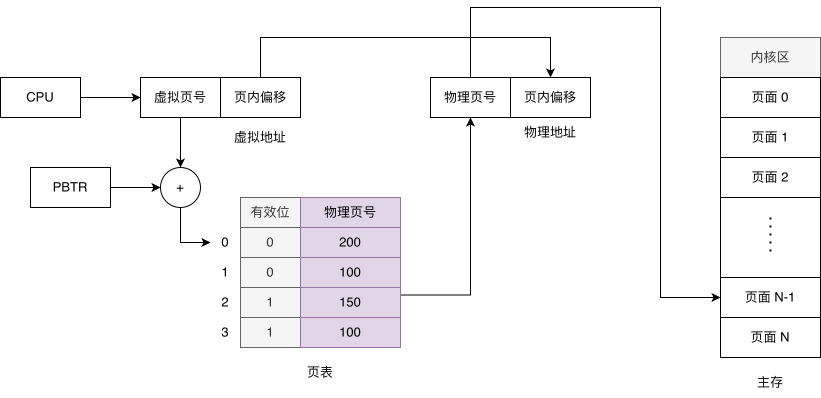
页式内存管理的基本思想是将 虚拟地址空间 分为大小固定的 页,将 物理内存 分为同样大小的 页框,然后通过 页表 建立从虚拟页到物理页框的映射。这样,进程的各个虚拟页就可以离散地装入不同物理页框。
注意
| 寄存器 | 含义 | 配合索引 |
|---|---|---|
| PTBR(Page Table Base Register) | 页表基址寄存器,保存当前进程页表起始地址 | 虚拟页号 |
| STBR(Segment Table Base Register) | 段表基址寄存器,保存当前进程段表起始地址 | 段号 |
表项地址还与表项大小有关,不能只说“基址加编号”;一般形式为“表基址 + 索引 × 表项大小”。
段式管理
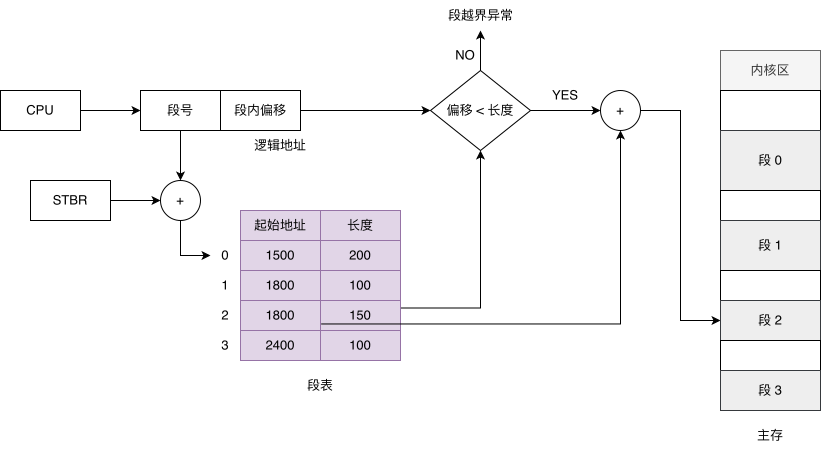
段式内存管理将程序的不同部分(例如 代码、数据和堆栈)划分为不同的 段(segments)。一个段内部的逻辑地址连续,并通过该段的基址与段内偏移定位;在基本分段存储管理中,每个段装入一段连续的物理内存,但不同段之间不要求相邻,因此整个进程的物理空间可以离散。
段式管理按程序的逻辑模块划分地址空间,便于按段实施 保护 和 共享。8086 的段寄存器寻址也使用“段”这一名称,但它是指令集地址形成机制,不能直接等同于这里由操作系统维护段表、段长与保护信息的分段存储管理。
下文介绍一下段式内存管理中的三个关键概念:段、段表 以及 地址转化。
段概念
- 每个段都有一个明确的角色,例如 代码段、数据段 或 堆栈段。
- 每个段都有一个 起始地址 和 长度。
- 段内的地址是连续的,但不同段之间的地址可以不连续。
段表
- 段表是一种数据结构,用于存储每个段的 基地址(在物理内存中的起始地址)和 段长(允许的段内偏移范围)。题目若把界限字段定义为“最大合法偏移”,比较符号需按题设调整。
- 当一个程序需要访问其内存段时,会使用 段号 和 段内偏移 作为地址。这个地址被称为 逻辑地址 或 段地址。
- 逻辑地址通过段表转换为 物理地址。
地址翻译
- 为了从逻辑地址获取物理地址,首先需要从逻辑地址中提取 段号,然后使用段号在段表中查找相应的基地址和限制。
- 然后,检查逻辑地址中的 偏移量 是否小于该段的限制。如果偏移量超出限制,则产生 段越界错误。
- 如果偏移量有效,则将偏移量加到段的基地址上,得到 物理地址。
段页式管理
段页式管理(paged segmentation)是一种将 段式内存管理 与 分页式内存管理 相结合的策略。 在段页式管理中,程序首先被划分为逻辑上的 段,然后每个段进一步被划分为固定大小的 页。 首先,操作系统通过 段表 对不同的段进行管理。 在每一个段的内部,采用 分页 的方式将段分为不同的页,实现虚拟页面到物理页面的映射。
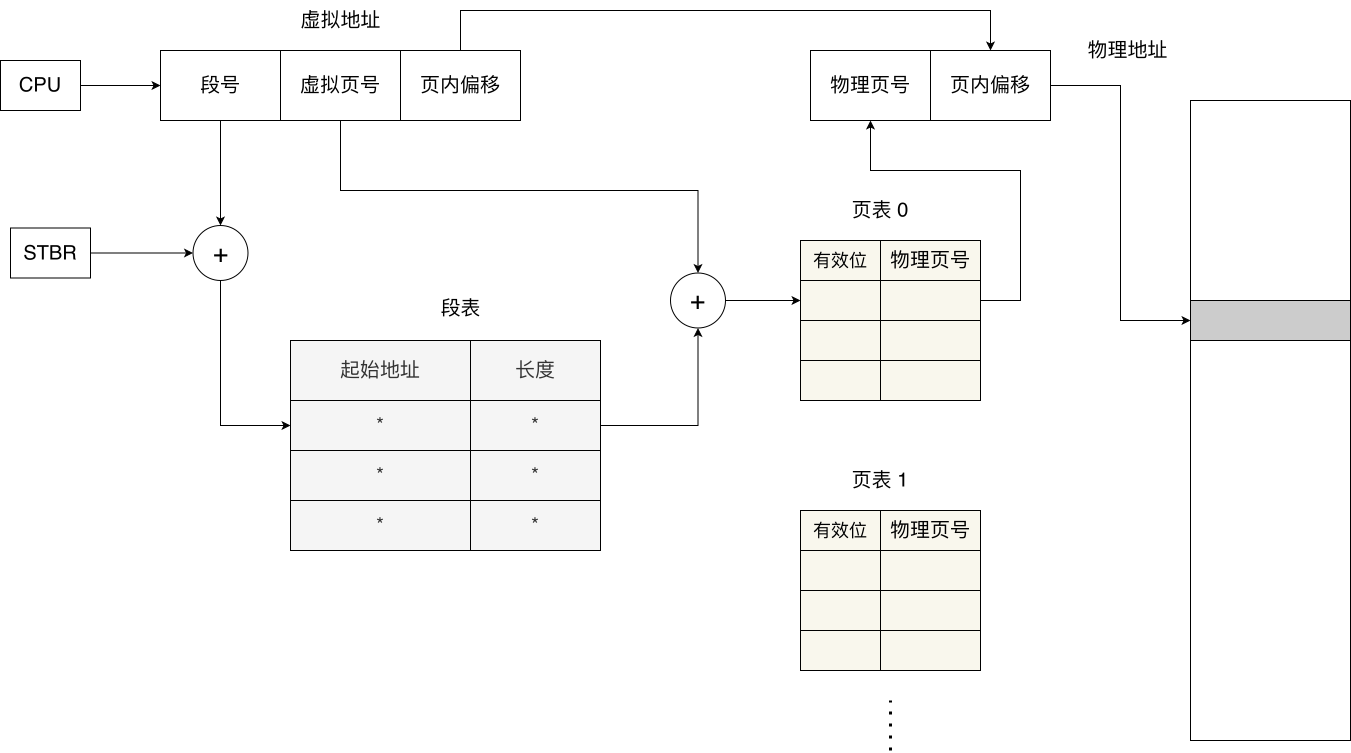
在使用段页式内存管理的策略时,虚拟地址可以拆分为三个部分:段号(Segment No)、页号(Page No)、页内偏移(Offset)。
在地址翻译的过程中,首先通过虚拟地址中的 段号 在段表中找到 页表的起始地址,接下来再通过 页号 在页表中找到该地址对应的 物理页面号。
它兼具分段的逻辑保护/共享能力与分页的离散分配能力。分页消除了段的外部碎片,但最后一页仍可能产生内部碎片;地址翻译也需要先查段表、再查页表,管理结构更复杂。