模式匹配
本页重点是 KMP 算法:能够构造 next 数组,并在失配时正确调整模式串位置。代码用于核对下标约定,复习时更应能在纸上还原比较过程、说明主串下标为何不需要回退。
学习定位:这一节要考的话其实就是 KMP 算法,会考察下 next 数组的构建 和 调整位置的方式。这里不据此推断考频;涉及算法过程时,仍应重点核对每次失配后的下标变化。
字符串模式匹配 是计算机科学中的基础问题,主要是在一个 主字符串 中查找一个 子字符串模式。
串的模式匹配概念
在介绍模式匹配算法之前,需要能够区分关于串的几个概念:
- 主串(Str / 主字符串):待搜索的那一整段字符串。
- 子串(Substr / 子字符串):主串中的某一段字符串
- 模式串(Pattern / 模式字符串):要在主串中查找的目标。
以及以下几个关于 模式匹配 的术语:
- 匹配:在主串中找到与模式串完全相同的子串
- 匹配位置:模式串在主串中出现的起始位置
- 失配:当前字符不匹配
模式匹配算法 将模式串与主串比较,尝试找到主串中与模式串完全相同的子串。
前后缀的口径:KMP 中说“最长相等前后缀”时,通常指同一串的非空真前缀和非空真后缀;它们不能等于整个串本身。空串长度记为 0,是没有相等非空真前后缀时的回退信息。
简单模式匹配算法
简单模式匹配算法(即暴力匹配 / 朴素匹配)的 基本思想 是:逐个检查 主串 的每一个位置,判断 从该位置开始的子串 是否与 模式串 完全相同。
算法描述
- 从 主串 的第一个字符开始,尝试与 模式串 匹配。
- 如果当前字符匹配,则继续比较下一个字符,依此类推。
- 如果在某一位置发生不匹配,则将 模式串 移动到 主串 的下一个起始位置,重新匹配。
- 如果某一段 子串 与 模式串 完全相同,则返回该 子串在主串中的起始位置。
- 如果扫描完整个 主串 都没有找到匹配的 子串,则返回 -1。
int simplePatternMatching(const char* mainStr, const char* pattern) {
    int m = strlen(mainStr);
    int n = strlen(pattern);

    // 如果主字符串的长度小于模式字符串的长度,直接返回 -1
    if (m < n) return -1;

    for (int i = 0; i <= m - n; i++) {
        int j;
        for (j = 0; j < n; j++) {
            if (mainStr[i + j] != pattern[j]) {
                break;
            }
        }
        // 如果 j 等于模式串的长度,说明已经找到匹配
        if (j == n) return i;
    }
    return -1;  // 没有找到匹配
}
简单模式匹配算法的 核心思路 其实就是将主串中的每个子串和模式串进行对比。举个例子,主串 abaaabc 和模式串 abc 进行简单模式匹配的过程如下;下方轨迹保留了每次起点右移的完整过程:
朴素模式匹配如何移动起始位置
逐步查看模式串 abc 在主串 abaaabc 上的每次对齐、失配位置与最终匹配位置。
从下标 0 开始a、b 匹配,在主串下标 2 处 c 与 a 失配。
设主串长度为 ,模式串长度为 。这个简单模式匹配算法的时间复杂度是 ,其中 是主字符串的长度, 是模式字符串的长度。更精确地说,最坏情况下需要在 个起点各比较至多 次;辅助空间复杂度为 。
KMP 算法
与 简单模式匹配算法 不同, KMP 算法 在发现不匹配的字符时能够避免不必要的比较,从而提高效率。
前缀与后缀
简单模式匹配 时间复杂度过高,因为每一次匹配失败都得从下一个位置重新开始。这就没有充分应用 模式串 的特性,比如对于字符串 abcdabc,我们可以发现:
- 其 前缀 包含
a,ab,abc,abcd等 - 起 后缀 包含
c,bc,abc,dabc等
abc 是在其 前缀 和 后缀 中都包含的部分,在字符串匹配时,我们可以充分利用该信息,匹配失败时,我们可以不用从下一个位置开始,而是从 模式串内部的某个位置 开始。
KMP 算法就是基于这个思想,其核心是一个称为“部分匹配表”或“前缀函数”的辅助数组(通常称为 next 数组),该数组用于确定当模式串在主串不匹配时应该如何有效地移动模式串。
算法描述
- 构建 部分匹配表(next 数组):
next[i]表示:当 模式串 在第 i 位 匹配失败 时,下一次 应该跳到的模式串位置。 - 不断进行 模式匹配,直到匹配成功或 主串 结束。
next 数组计算
如果 模式串 为 pattern,用通俗的话来说,next[k] 就是第 k 个字符的 前缀字符串 pattern[0:k-1](pattern 的前 k 个字符构成的子串,不包含当前字符)的最长相同 前缀 和 后缀 的长度。
一句式定义:如果模式串为
pattern,next[k]就是第 k 个字符之前的前缀字符串pattern[0:k-1]的最长相同前缀和后缀的长度;本页随后以next[0] = -1的教材式约定表示这个回退位置。
以 ababac 字符串为例,可以得到以下的 next 数组:
模式串 pattern |
a | b | a | b | a | c |
|---|---|---|---|---|---|---|
下标 index |
0 | 1 | 2 | 3 | 4 | 5 |
pattern[0:index] 的最长相等前后缀长度 |
0 | 0 | 1 | 2 | 3 | 0 |
教材式 next[index] |
-1 | 0 | 0 | 1 | 2 | 3 |
一般而言,next 数组 中的第一个元素被设置为 -1(因为第一个字符不存在 前缀子串)。
教材式约定重述:一般而言,next 数组中的第一个元素被设置为 -1,因为第一个字符不存在前缀子串。若改用 LPS,则第一项为 0;两种约定必须分别使用对应的跳转公式。
以 c 字符为例,我们需要计算 next[5],所以需要统计 c 的 前缀字符串 ababa 的最长相同 前缀 和 后缀 的长度,可以观察到,最长的相同 前缀 和 后缀 为 aba,长度为 3,所以 next[5] = 3。
下标口径:本页表格与
nextval使用教材中常见的next[0] = -1约定;后面的 C 代码使用现代实现常见的 LPS(最长相等真前后缀长度)数组,满足lps[0] = 0。两者可以相互转换,但做题时不能混用跳转公式。
使用 next 调整位置
用 i 表示 主串 当前下标,用 j 表示 模式串 当前下标:
- 如果
main[i] == pattern[j],将i和j都向后移动一位。 - 如果
main[i] != pattern[j]:- 如果
j == 0,将i向后移动一位。 - 如果
j != 0,将j移动到next[j]。
- 如果
以下图为例,说明 主串 “ababcabcabababd” 和 模式串 “ababd” 的匹配过程。
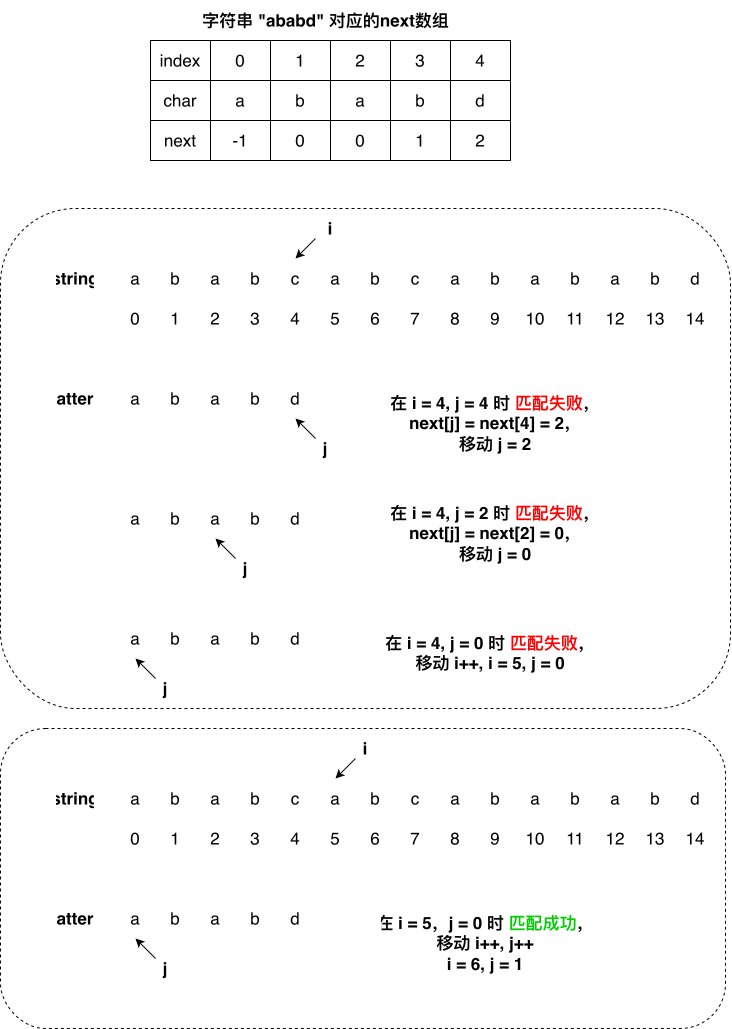
KMP 失配时如何连续回退模式串下标
沿原图的四个状态查看 i 保持或前移、j 按 next 回退,以及回退后重新匹配成功的过程。
i=4,j=4 失配主串字符 c 与模式串字符 d 失配;next[4]=2,所以 i 保持 4,j 回退到 2。
算法实现
下面的代码用来核对 LPS 约定下的实现细节;复习时应重点能在纸上模拟 KMP 算法 的比较与回退过程。
void computeLpsArray(const char* pattern, int m, int* lps) {
    int len = 0;
    lps[0] = 0;
    int i = 1;

    while (i < m) {
        if (pattern[i] == pattern[len]) {
            len++;
            lps[i] = len;
            i++;
        } else {
            if (len != 0) {
                len = lps[len - 1];
            } else {
                lps[i] = 0;
                i++;
            }
        }
    }
}

int KMP(const char* mainStr, const char* pattern) {
    int m = strlen(mainStr);
    int n = strlen(pattern);

    // 这里采用“空模式在下标 0 匹配”的常见约定;题目另有规定时按题设。
    if (n == 0) return 0;

    int lps[n];
    computeLpsArray(pattern, n, lps);

    int i = 0, j = 0;
    while (i < m) {
        if (pattern[j] == mainStr[i]) {
            i++;
            j++;
        }

        if (j == n) {
            return i - j;
        } else if (i < m && pattern[j] != mainStr[i]) {
            if (j != 0)
                j = lps[j - 1];
            else
                i++;
        }
    }

    return -1; // 没有找到匹配
}
复杂度与核心不变量
构造 LPS 数组需要 时间;匹配阶段中,主串下标 只会前进,模式串下标 失配时按 LPS 回退但不会让 回退,因此总比较次数是线性的。故 KMP 的总时间复杂度为 ,LPS 辅助数组空间复杂度为 。
这也是 KMP 与朴素匹配最关键的区别:失配时已经确认的主串字符不必再作为新起点重新比较;LPS/next 只利用模式串内部的重复结构调整 。
修正后的 next 数组
其实上述内容就是 kmp 算法 的核心了,当然有时候也会涉及到这样一个概念: 修正后的 next 数组。
这个概念其实来源于早期教材(特别是严蔚敏的《数据结构》), 修正后的 next 数组 常称作 nextval 数组,其目的是避免某些情况下的冗余匹配。
nextval 数组是为了修正 next 数组存在的以下问题:当 pattern[i] == pattern[next[i]] 时,如果直接使用 next[i],会导致重复比较已经失败过的字符。
为了解决这个问题,定义了 nextval:其核心思想是:避免跳转到与当前位置字符相同的地方,减少无意义的重复比较。
- 如果
pattern[i] == pattern[next[i]]→ 则nextval[i] = nextval[next[i]] - 否则 →
nextval[i] = next[i]
nextval 的构建规则如下:
if (next[i] == -1) {
    nextval[i] = -1;
} else {
    int k = next[i];
    while (k != -1 && pattern[i] == pattern[k]) {
        k = nextval[k]; // 向前继续跳
    }
    nextval[i] = k;
}
需要注意的,nextval 的计算过程是迭代向前的,因为我们希望减少无意义的比较,所以要争取找到一个不同的字符。
以字符串 ababaa 为例,我们首先可以计算出其 next 数组:
pattern |
a | b | a | b | a | a |
|---|---|---|---|---|---|---|
index |
0 | 1 | 2 | 3 | 4 | 5 |
next |
-1 | 0 | 0 | 1 | 2 | 3 |
然后计算出 nextval 数组:
pattern |
a | b | a | b | a | a |
|---|---|---|---|---|---|---|
index |
0 | 1 | 2 | 3 | 4 | 5 |
nextval |
-1 | 0 | -1 | 0 | -1 | 3 |
nextval 如何跳过重复字符比较
逐项构造模式串 ababaa 的 nextval,观察字符相等时为何继续引用更早的 nextval 值。
下标 0:没有可回退前缀nextval[0] = -1。当前没有更短的可比较真前后缀。
nextval[0] = -1nextval[1] = 0pattern[2] = a, pattern[next[2]] = pattern[0] = a,相等,因此nextval[2] = nextval[0] = -1pattern[3] = b, pattern[next[3]] = pattern[1] = b,相等,优化:nextval[3] = nextval[1] = 0pattern[4] = a, pattern[next[4]] = pattern[2] = a,相等,优化:nextval[4] = nextval[2] = -1nextval[5] = 3(pattern[5] = a, pattern[next[5]] = pattern[3] = b,不相等,保留原值)
其实 KMP 的现代实现中一般使用 next 数组就足够了;在不同教材或代码中,它也常被命名为 LPS 或前缀函数。nextval 主要是教材式 next 的一种常数级优化,特别是在大量重复字符的模式串里可避免重复比较,但不会改变 KMP 的 渐近复杂度。本文代码以 LPS(最长相等真前后缀长度)数组呈现现代约定;nextval 专门避免跳到与当前失配字符相同的位置而产生重复比较。
执行轨迹复述与易错点
前后缀为何能减少回退:abc 是在 abcdabc 的前缀和后缀中都包含的部分。在字符串匹配时,可以充分利用该信息;匹配失败时,不必从下一个位置重新开始,而是从模式串内部的某个位置继续比较。
简单模式匹配算法的核心思路就是将主串中的每个子串和模式串逐字符对比。主串 abaaabc 与模式串 abc 的例子中,模式串先后从主串下标 0、1、2、3、4 开始尝试;前四次在某个字符处失配,最后一次完整匹配。每一次匹配失败都从下一个位置重新开始,因此没有利用模式串已经匹配成功的部分。
KMP 算法在发现不匹配字符时能够避免不必要的比较。它充分利用模式串的前缀和后缀信息:匹配失败时,不必把主串下标退回,也不用简单地从主串的下一个起点重来,而是把模式串下标跳到 next 或 LPS 指定的位置。部分匹配表用于确定模式串失配时应该如何有效移动;不断进行模式匹配,直到匹配成功或主串结束。
以模式串 ababac 为例,计算 next[5] 时要考察当前字符 c 之前的前缀字符串 ababa。它的最长相同前缀和后缀是 aba,长度为 3,所以教材式数组中 next[5] = 3。使用 next 调整位置时,若当前字符匹配,则主串下标和模式串下标都向后移动;若失配,则只按当前约定调整模式串下标。这里最容易错的是把教材式 next、LPS 和 nextval 的下标规则混在同一道题中。