格式和寻址方式
复习提示(高优先级):指令格式与寻址方式需要和 CPU 数据通路、控制器以及存储系统联合分析。
组成原理的综合分析可以沿两条主线建立:Cache 与虚拟存储器构成访存链路,指令系统与 CPU构成执行链路。两条主线内部的知识点相互耦合;做题时应把指令、地址、数据通路和存储层次放在同一过程里分析。
指令格式
指令的功能就是 对某些数据 进行 某种操作。
所以指令中主要包含两个部分:操作码(opcode)以及 地址(address)。
- 操作码(opcode)就是决定了指令的类型:
- 这个指令是干嘛的?进行哪种操作?
- 地址是一个通用含义,指的是操作的对象:
- 可以是一个 内存地址(
<addr>) - 也可以是 CPU 中的一个寄存器编号(
<reg>) - 也可以是一个 立即数(
<imm>)
- 可以是一个 内存地址(
指令类型
根据操作码分类
指令根据其 操作码(opcode)的不同可以分为以下类别:
- 数据传输指令
MOV:将数据从一个位置传输到另一个位置,可以是寄存器到寄存器、内存到寄存器、寄存器到内存等。PUSH:将数据(通常是寄存器中的值)推入堆栈。POP:从堆栈中弹出数据并存储到寄存器中。
- 算术和逻辑运算指令
ADD、SUB、MUL、DIV:执行算术运算,如加法、减法、乘法和除法。AND、OR、XOR、NOT:执行逻辑运算,如按位与、按位或、按位异或和按位取反。INC、DEC:递增和递减操作数的值。CMP:用于比较两个值,并根据结果设置标志寄存器的状态。
- 控制转移指令
JMP:用于无条件跳转到指定的目标地址。Jxx:条件跳转指令,根据特定的条件(如零标志、进位标志等)来决定是否跳转。CALL:调用子程序或函数。RET:从子程序返回。
- 输入/输出指令
IN:从外部设备或端口读取数据。OUT:向外部设备或端口发送数据。
- 字符串操作指令(String Instructions):
MOVS、LODS、STOS、CMPS:用于在内存中执行字符串操作,如移动、加载、存储、比较。
- 自陷/软件中断指令(Trap / Software Interrupt Instructions):
INT:显式触发软件中断,常用于受控地转入操作系统提供的服务入口。
- 中断控制指令(Interrupt Control Instructions):
CLI、STI:分别清除和设置 CPU 的中断标志;在 x86 中属于受特权级限制的指令,不能把它们误认为协处理器指令。
根据地址个数分类
根据指令中的 地址 个数,可以将指令划分为以下类型。 这些地址可以是 寄存器、内存地址,也可以是 立即数。

| 指令类型 | 指令格式 | 含义 |
|---|---|---|
| 零地址指令 | op |
执行操作 op,操作数隐含在栈顶或专用寄存器中 |
| 一地址指令 | op A1 |
,对 操作并将结果存回 |
| 二地址指令 | op A1, A2 |
,结果覆盖 |
| 三地址指令 | op A3, A1, A2 |
,结果写入 |
定长和变长指令
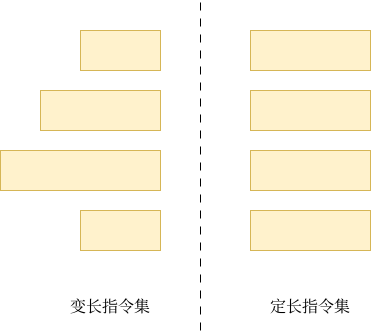
指令长度的设计可以分为两类:
定长指令集:在选定的指令编码模式中,所有指令的长度完全相同 → 典型教学模型:MIPS、AArch64 等 RISC 风格编码 → 优点:解码简单、高效 → 缺点:指令中可能出现浪费空间的无效字段
变长指令集:不同指令具有不同长度 → 典型架构:x86(CISC) → 优点:编码更紧凑,能支持更复杂操作 → 缺点:解码过程复杂,需要准确识别指令边界
注意:这两种设计思路分别带来两个常见问题:
- 在 定长指令集 中,所有指令长度固定,而不同指令所需的 地址字段 个数不一样,如何统一表示?
- 在 变长指令集 中,指令长度不固定,CPU 又如何判断指令边界(即每条指令的起始和结束位置)?
🧩 解决思路
问题 1:定长指令中地址字段数量不统一怎么办?
解决方法是使用 无效字段填充。
即:当某条指令所需的 地址字段 不足以填满整个固定长度时,剩余部分使用 填充值(无效字段)占位。这些填充值不会影响指令执行,仅用于保证每条指令长度一致,简化硬件解码逻辑。
问题 2:变长指令中如何识别指令边界?
一种常用方案是由操作码和后续字段共同给出长度规则;某些 ISA 还会引入 指令前缀。
即:CPU 先译码操作码,再按该操作码规定读取寻址方式、寄存器、立即数、位移等后续字段,从而确定整条指令边界。前缀字段或操作码高位的长度标志只是可选设计,不是所有变长 ISA 都有一段单独的“长度前缀”。
虽然这种方式增加了解码复杂度,但换来了更大的编码灵活性与指令集的扩展能力。
操作码扩展编码
上面的指令前缀是为了让 CPU 判断整条指令的长度;而在 定长指令系统 中,还有一种与之思想类似、但用途不同的设计——操作码扩展编码。
其核心思想是:让操作码本身具有层次结构。当 CPU 解码时,如果发现当前操作码属于"扩展前缀",就继续读取后续位,直到得到完整的操作码。
因此,指令系统通常采用:
可变长度操作码 + 定长指令字 的方式,并要求这些 操作码 遵循前缀编码设计原则。
🌟 先举个简单的例子:
假设我们设计如下 操作码长度规则:
- 三地址指令使用 4 位 操作码
- 二地址指令使用 6 位 操作码
- 一地址指令使用 8 位 操作码
为了防止解析冲突,必须满足 前缀码 的要求:
- 任意一个 4 位 操作码不能是任何 6 位 或 8 位 操作码的前缀
- 任意一个 6 位 操作码不能是任何 8 位 操作码的前缀
这样,每条指令的 操作码 就能唯一识别其类别与长度,避免歧义,并保持系统的可扩展性和解码自同步。
🌟 再举个复杂的例子:
假设某指令系统指令长 16 位,操作码字段为 4 位,地址码字段为 4 位,采用扩展 操作码 技术,形成 三地址指令 15 条、二地址指令 12 条、一地址指令 63 条、零地址指令 16 条。
那么 三地址指令 格式如下:
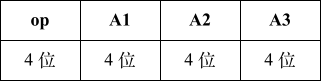
二地址指令 复用 三地址指令 的 A1 字段,一地址指令 复用 三地址指令 的 A1 和 A2 字段,零地址指令 复用 三地址指令 的 A1、A2 和 A3 字段。
可以通过树形扩展得到不同指令的 op 前缀:
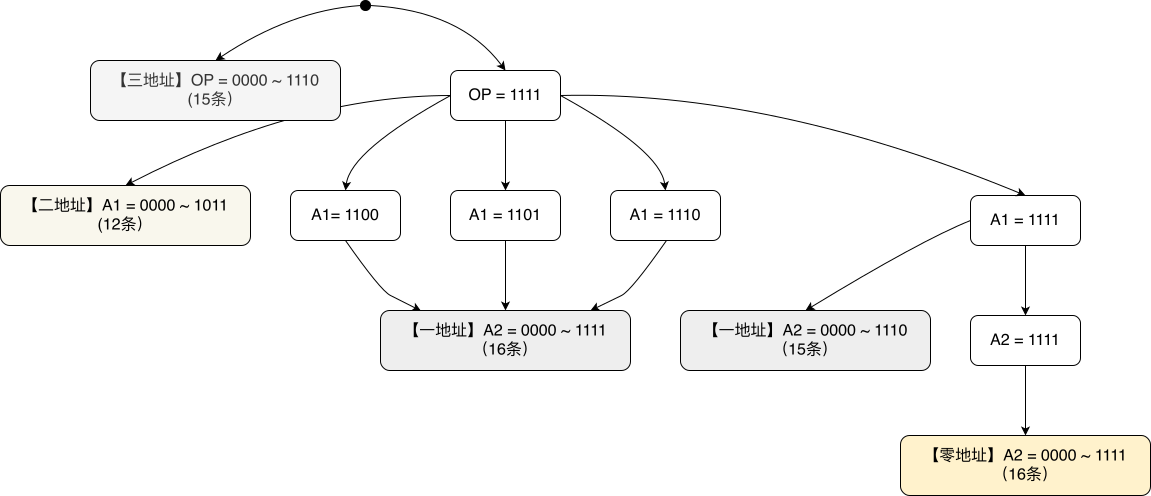
沿着树的边一直走到叶子结点,可以得到如下格式的指令:
| 指令类型 | 操作码 | 地址码 1 | 地址码 2 | 地址码 3 |
|---|---|---|---|---|
| 三地址指令(15 条) | 0000~1110 |
A1 | A2 | A3 |
| 二地址指令(12 条) | 1111 0000~1111 1011 |
— | A2 | A3 |
| 一地址指令(63 条) | 1111 1100 0000~1111 1111 1110 |
— | — | A3 |
| 零地址指令(16 条) | 1111 1111 1111 0000~1111 1111 1111 1111 |
— | — | — |
注意
操作码扩展编码虽然属于计算机组成原理,但它所采用的设计思想,在计算机网络 中同样十分常见。
例如,变长子网划分也是按照前缀不断扩展的方式划分地址空间:每向下一层扩展 1 位,地址空间便减半;最终,每个子网都对应二叉树上的一个叶子节点。
从二叉树的角度来看,两者都是不断将一个大的编码空间递归划分为更小的子空间:
          根节点
             │
      扩展一位(二选一)
          /       \
        0           1
      /  \        /  \
     …   …      …    …
因此,无论是 CPU 的操作码设计,还是 IP 地址的 VLSM 划分,本质上都是利用 前缀编码(Prefix Code) 对有限的编码空间进行高效划分。只不过,一个划分的是 指令编码空间,另一个划分的是 IP 地址空间。
寻址方式
计算机中的 寻址方式(Addressing Modes)是指在 指令中如何指定操作数的位置或地址,寻址方式可以被归为以下种类:
立即数寻址
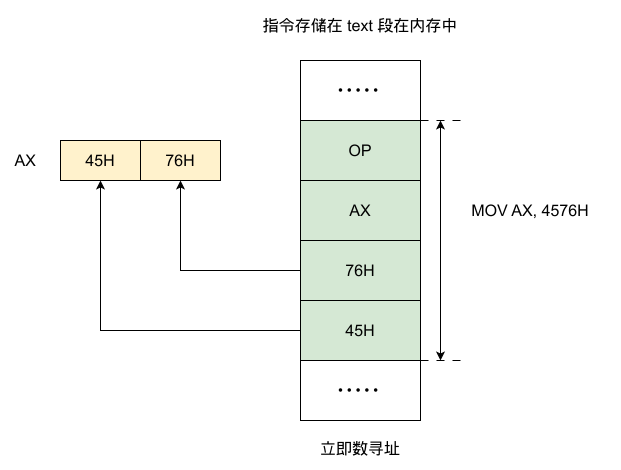
立即数寻址(Immediate Addressing)是一种将 常量值直接嵌入指令中 的寻址方式,常用于赋值、初始化、比较等基本操作。
在 立即数寻址 之中,操作数本身就是指令的一部分,而不是从寄存器或内存中取得。这种寻址方式不涉及额外的地址计算,执行效率较高。
举个实际例子,下图是指令 MOV AX, 4567H 的存储结构和执行示意图,指令直接将 立即数 4567H 写入寄存器 AX:
示例应用
| 应用 | 示例说明 |
|---|---|
| 加载常量 | MOV AX, 5 —— 将常数 5 写入 AX |
| 比较固定值 | CMP AL, 0 —— 判断 AL 是否为零 |
注意:寻址方式是针对指令还是操作数的?
寻址方式针对的是每一个操作数,而不是整条指令。
因此:
MOV AX,1234H
最严谨的表述是:
AX—— 寄存器寻址1234H—— 立即寻址- 整条指令同时包含寄存器寻址和立即寻址。
不过在考题或教材中,如果说"该指令采用立即寻址",通常是约定俗成地指源操作数采用立即寻址。因此考试时可以按这个习惯理解,不会与标准定义冲突。
寄存器寻址
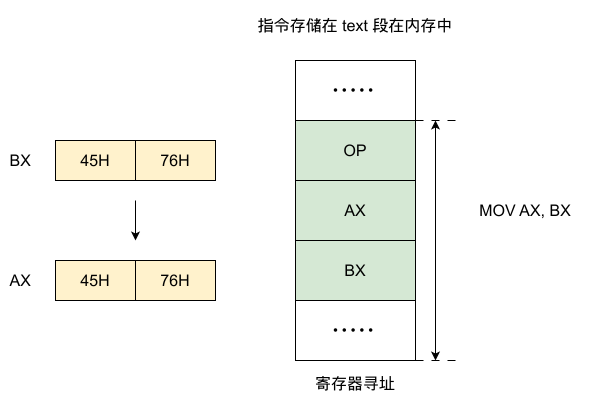
寄存器寻址(Register Addressing)是一种将操作数存储在寄存器中的寻址方式。在这种模式下,指令通过指定寄存器来访问操作数,寄存器本身就是操作数的存储位置。
举个实际例子,指令 MOV AX, BX 表示将寄存器 BX 中的值复制到寄存器 AX 中:
示例应用
| 应用 | 示例说明 |
|---|---|
| 拷贝寄存器内容 | MOV AX, BX —— 将 BX 内容拷贝到 AX |
| 比较寄存器 | CMP AX, BX —— 比较 AX 与 BX 的内容 |
直接寻址
直接寻址(Direct Addressing)是一种通过 在指令中显式给出操作数的内存地址 来访问数据的方式,适用于访问固定位置的数据。
在 直接寻址 中,指令中包含了操作数在内存中的确切地址。CPU 在执行指令时,会直接从该地址读取或写入数据,不依赖寄存器辅助寻址。
举个实际例子,下图是指令 MOV R1, [1000] 的执行示意图,以 立即数 1000 作为访存地址,指令从内存地址 1000 的单元读取数据并加载到寄存器 R1 中:
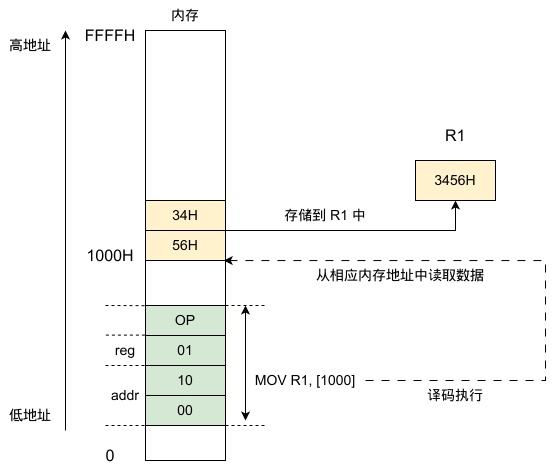
若指令地址字段为 ,直接寻址的有效地址为 。
示例应用
| 应用 | 示例说明 |
|---|---|
| 访问固定内存 | MOV AX, [0x1234] —— 读取内存地址 0x1234 的内容 |
| 设置显存颜色值 | MOV [0xB8000], AL —— 设置文本模式字符颜色 |
注意:
IN AL, 60H的端口号是独立 I/O 编址中的立即端口地址,不是这里讨论的直接内存寻址;不要把二者混为一谈。上图使用 8086 风格的简化例子,直接以物理地址说明访问过程。
但是在现代计算机操作系统中,由于使用了虚拟存储器,用户程序中的内存地址通常是虚拟地址;在访问实际物理内存之前需要经过一次地址翻译。
间接寻址
间接寻址(Indirect Addressing)是一种通过 寄存器或内存中的地址来访问实际数据地址 的方式,适用于访问指针、链表等动态结构。
在 间接寻址 中,指令中提供的是一个地址的“指针”,实际的数据地址存储在寄存器或内存单元中。CPU 先访问该中间地址,再通过它获取最终的操作数地址。
举个实际例子,下图是指令 MOV R1, [R2] 的执行示意图,访存地址间接地存储在寄存器 R2 中,指令首先从 R2 中读取目标地址,然后在相应的地址中读取数据加载进入 R1 中:
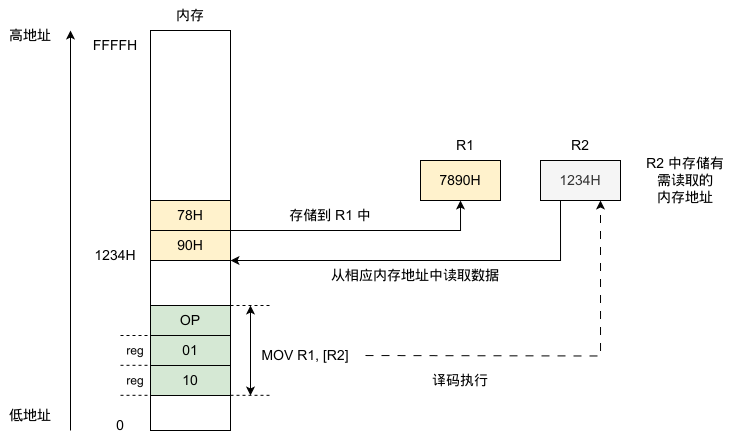
间接寻址包含多种类型,其中最常见的是 寄存器间接寻址:
操作数的地址保存在寄存器中,CPU 通过这个寄存器中存储的地址访问内存中的操作数。
若寄存器 中保存有效地址,则寄存器间接寻址满足 。内存间接寻址则需要先按指令地址字段访问一次内存,典型地可写为 ,因此通常比寄存器间接多一次访存。
示例应用
| 应用 | 示例说明 |
|---|---|
| 通过指针访问数据 | MOV AX, [BX] —— BX 存储了目标地址 |
基址寻址
基址寻址(Base Addressing)是一种通过 基址寄存器与偏移值相加 来访问结构体字段或局部变量的方式,常见于函数调用过程中的栈帧操作。

若基址寄存器内容为 ,形式地址或位移量为 ,则 。
8086 可以用于基址寻址的寄存器实际上有两个:
- BX(Base Register):用于访问数组或结构体的基础地址
- BP(Base Pointer):用于访问函数栈帧的基础地址
示例应用
| 应用 | 示例说明 |
|---|---|
| 栈帧内访问局部变量或参数 | MOV AX, [BP - 2]、MOV AX, [BP + 6] |
| 访问数组中的元素 | MOV AX, [BX + 4] |
函数栈帧访问
程序中最常见的是函数调用,参考函数调用时内存结构。下图的 BP 偏移量采用 16 位 x86 风格的示意,BP 用于指定函数栈帧基址;参数、返回地址和局部变量的具体偏移取决于调用约定、位宽和函数序言,不能视为所有程序的固定布局。
例如
高地址
+-----------------+
| 参数2           |  BP+6
+-----------------+
| 参数1           |  BP+4
+-----------------+
| 返回地址        |  BP+2
+-----------------+
| 旧BP            |  BP
+-----------------+
| 局部变量1       |  BP-2
+-----------------+
| 局部变量2       |  BP-4
+-----------------+
低地址
于是:
MOV AX, [BP+4]    ; 第一个参数
MOV BX, [BP-2]    ; 局部变量
结构体和数组访问
在结构体和数组访问中,8086 中用 BX 指定数据结构在内存中的起始地址。
BX
 │
 ▼
1000: 10
1001: 20
1002: 30
1003: 40
于是
; 访问数组首地址 + 2
MOV AL,[BX+2]
变址寻址
变址寻址(Indexed Addressing)是一种通过 变址寄存器的值加上偏移量 来获取操作数地址的寻址方式,通常用于数组或表格中元素的访问。

若变址寄存器内容为 ,形式地址为 ,则典型变址寻址的有效地址为 。当一条指令同时使用基址寄存器和变址寄存器时,属于基址变址寻址,典型形式为 ,不要把它误作只有一种寄存器参与的纯变址寻址。
示例应用
| 应用 | 示例说明 |
|---|---|
| 多维数组访问 | MOV AX, [BX + SI] —— 基址变址组合,用基准地址与索引定位元素 |
| 结构体数组成员访问 | MOV AX, [DI + SI*4] —— x86-32/64 风格的缩放变址,每个元素占 4 字节 |
| 动态偏移的数据结构遍历 | MOV AL, [BX + CX] —— 使用运行时索引访问 |
基址寻址和变址寻址的区别
| 比较项 | 基址寻址 | 变址寻址 |
|---|---|---|
| 典型形式 | [BR + A] |
[IX + A] |
| 静态基准 | 基址寄存器 BR 通常在一组访问中保持稳定 |
形式地址 A 是指令给出的静态位移 |
| 随访问变化的量 | 根据字段选择的位移 A |
变址寄存器 IX,常随循环或下标变化 |
| 典型用途 | 结构体、栈帧 | 数组、循环 |
相对寻址
相对寻址(Relative Addressing)是一种根据 当前指令地址(PC)与偏移量 来确定跳转或访问目标位置的方式,广泛应用于控制流指令。
在 相对寻址 中,以当前程序计数器(PC)作为基准,通过加上一个有符号的偏移量来计算跳转目标地址。这种寻址方式便于编写可重定位代码。
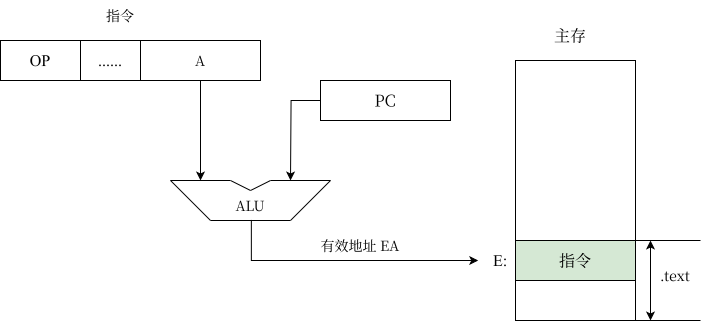
若采用当前指令执行时约定的 PC 基准值,形式地址为有符号偏移 ,则 。具体 ISA 可能以当前指令地址或下一条指令地址作为 PC 基准。
示例应用
| 应用 | 示例说明 |
|---|---|
| 条件跳转(分支) | JZ LABEL —— 条件成立时跳转到相对偏移处 |
| 循环控制 | LOOP LOOP_START —— 按 ISA 规定的相对位移回到循环起点 |
| 实现函数局部跳转表 | JMP [PC + offset](某些架构中) |
现代主流 ISA 广泛使用 PC 相对寻址实现条件分支和直接跳转;具体 jmp、call 或 branch 是否采用 PC 相对、绝对或间接寻址,应以该 ISA 的指令编码为准。
例如,C 代码:
if (a == 0)
    foo();
编译出来(x86-64)通常类似:
cmp eax, 0
je  .L1        ; 跳转到标签

...

.L1:
call foo
实际上机器码并不是存储 .L1 的绝对地址,而是:
je +0x18
CPU 实际计算 目标地址 = 下一条指令地址(RIP) + 偏移,所以 JZ LABEL 实际上就是 JZ +offset。其中 offset = LABEL - 下一条指令地址。
堆栈寻址
堆栈寻址(Stack Addressing)是一种通过 栈指针或基址指针 来访问栈中数据的方式,广泛应用于函数调用过程中的参数传递和返回值保存。
在 堆栈寻址 中,利用 SP(栈指针)或 BP(基址指针)定位栈中元素,通过栈顶向下或向上偏移来读取或写入局部变量、返回地址等。通常与 PUSH、POP、CALL、RET 等指令结合使用。
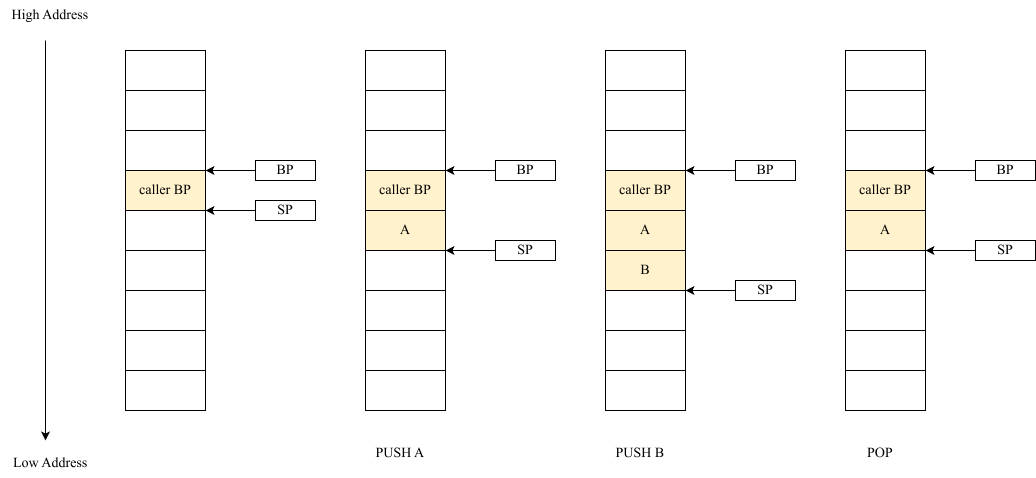
示例应用
| 应用 | 示例说明 |
|---|---|
| 函数调用和返回 | CALL FUNC、RET —— 使用栈保存返回地址 |
| 保存和恢复寄存器值 | PUSH AX、POP AX |
寻址方式对比
下表给出了各个 寻址方式 的核心区别:
| 寻址方式 | 描述 | 示例 |
|---|---|---|
| 立即寻址 | 操作数直接包含在指令中 | MOV R1, #5 |
| 寄存器寻址 | 操作数在寄存器中 | ADD R1, R2 |
| 直接寻址 | 操作数的内存地址直接包含在指令中 | MOV R1, [1000] |
| 间接寻址 | 操作数地址保存在寄存器或内存单元中 | MOV R1, [R2] |
| 基址寻址 | 基址寄存器与偏移量相加得到有效地址 | MOV R1, [R2 + 4] |
| 变址寻址 | 基准地址与运行时索引相加,常用于数组 | MOV R1, [R2 + R3] |
| 相对寻址 | PC 基准值与有符号偏移相加 | JMP LABEL |
| 堆栈寻址 | 通过 SP 隐含访问栈顶操作数 | PUSH R1 |
指令字段与有效地址的统一推导
一条指令字的位数有限。若操作码字段有 位,最多可表示 种编码;若直接地址字段有 位并按字节编址,最多能直接表示 个字节地址。操作码、寄存器号、寻址方式、立即数和地址字段共享同一条指令的空间,因此“操作码更多”和“直接寻址范围更大”通常不能同时无代价获得。扩展操作码正是利用某些指令地址字段较少这一事实,把空出的位并入操作码来增加指令种类。
有效地址(EA)是访问内存操作数时真正送到 MAR 的地址;立即数和寄存器寻址的操作数不必再访问主存。常用写法可统一为:
| 方式 | 操作数或 EA | 主要代价与用途 |
|---|---|---|
| 立即寻址 | 操作数就是指令中的常数 | 无额外数据访存,常数位数受指令长度限制 |
| 寄存器寻址 | 操作数在指定寄存器 | 速度快,但寄存器数量有限 |
| 直接寻址 | 地址字段决定可达范围 | |
| 寄存器间接 | 寄存器保存地址,适合指针 | |
| 存储器间接 | 先读出真正地址,通常多一次主存访问 | |
| 基址或变址 | 或 | 分别适合重定位基准和数组下标 |
| 相对寻址 | 偏移较短,但可在当前位置附近跳转 |
括号表示“取该寄存器或存储单元中保存的值”,不是数学上的优先级装饰。题目给出基址、变址和位移时,应先计算 EA,再访问该 EA 指向的内容;若指令是取地址而不是取数,则到 EA 为止,不要额外再解引用一次。
相对寻址的位移 通常用补码表示。若它有 位,以字节为单位时可表达的有符号偏移范围约为 到 ;有些 ISA 按指令字或对齐单位缩放偏移,实际范围须乘相应单位。顺序 PC 是“当前指令地址”还是“下一条指令地址”也由 ISA 定义,计算分支目标前必须先看题设。
地址个数影响代码长度和访存次数
三地址指令可显式给出两个源和一个目的,表达式步骤少但指令字段较长;二地址指令常让一个操作数同时作为结果,需注意它会被覆盖;一地址指令多以累加器为隐含操作数;零地址指令把操作数隐含在栈顶,适合后缀表达式。地址数越少不代表总程序一定更短,因为中间结果可能需要额外的装入、保存或压栈指令。
估算执行时间时,应区分“取指令”与“取操作数”。立即数和寄存器寻址除取指外通常不需要额外主存数据访问;直接寻址通常还需一次数据访存;存储器间接寻址先读出有效地址再读数据,通常至少多一次。若指令本身还要写回内存,写回又是单独的总线或存储器操作。题目给出存储周期数时,应按实际读写次数列出,不能只按寻址方式名称记一个固定数字。