Cache
复习提示(高优先级):把映射方式、地址字段、替换算法和写策略串成一次完整的 Cache 访问流程。
Cache 与虚拟页式存储器常在同一访存过程中连续出现。映射方式、地址结构、替换算法和写策略都需要深入掌握。
Cache 原理
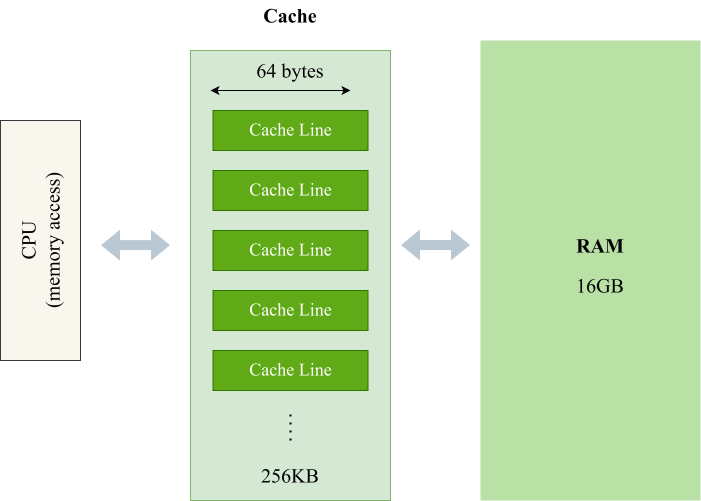
缓存 是一种临时存储数据的硬件或软件组件,旨在加快后续对该数据的访问速度。当您请求数据时,计算机会先检查 缓存 中是否存在该数据。如果存在(称为 “缓存命中”,Cache Hit),则可以直接从 缓存 中获取数据,而无需访问内存,从而节省时间和资源。如果 缓存 中不存在该数据(称为 “缓存未命中”,Cache Miss),则需要从内存获取数据,并将其存储在 缓存 中,以备将来使用。
Cache 工作原理
缓存(cache)是计算机系统中的一种用于加速数据访问的技术,其原理是在高速存储介质中暂时存储常用数据,以便更快地满足后续的访问请求。
缓存 对于程序执行的加速主要来自于 计算机程序 的 时间局部性(Temporal Locality)和 空间局部性(Spatial Locality):
时间局部性
时间局部性指的就是 “刚刚用过的数据,很可能很快又会被用到”。
这种特性常见于 循环结构和频繁访问的变量,例如循环中的计数器或者经常读取的配置值:
int sum = 0;
int arr[1000];

// 初始化数组
// ....
// 访问同一个变量 i 很多次
for (int i = 0; i < 1000; i++) {
    sum += arr[i];   // 访问 arr[i]
    sum += arr[i];   // 再次访问 arr[i]
}
在 缓存 设计中,利用 时间局部性 意味着一旦数据被加载到 缓存 中,它应该在那里保留一段时间,因为很可能很快会再次需要它。
空间局部性
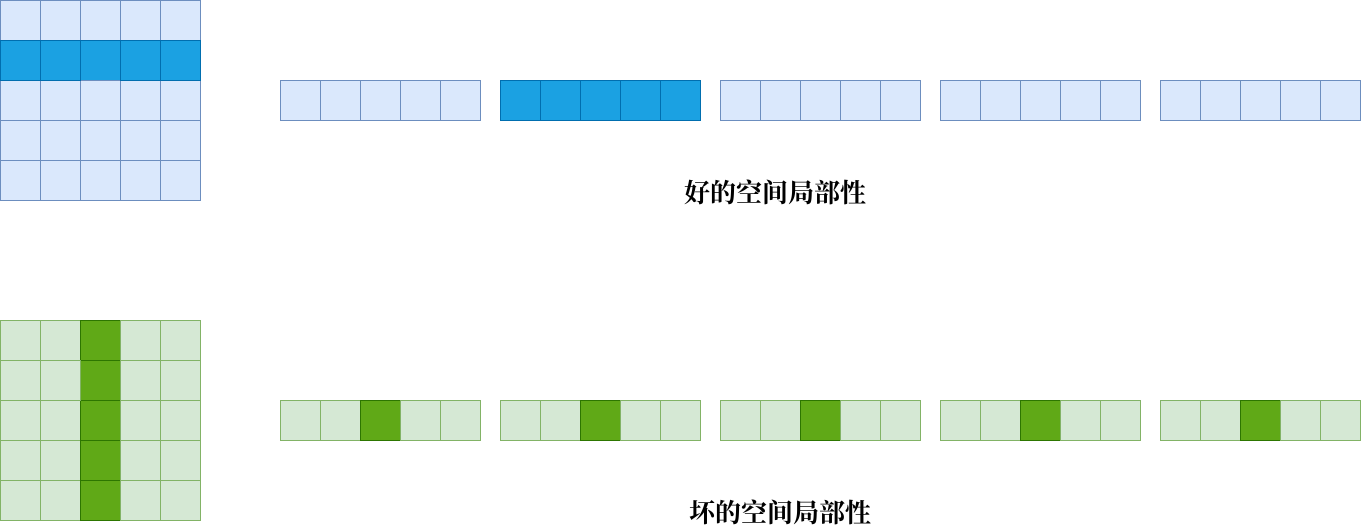
如果一个数据项被访问,那么存储在其附近的数据项也很可能在不久的将来被访问。
这种特性在数组遍历或结构体访问时尤为明显,因为这些数据元素通常在内存中是连续存储的。
利用 空间局部性 的 缓存 设计会在访问一个数据项时,同时把它附近的数据也加载到 缓存 中,因为这些数据很可能在接下来的操作中被用到。
Cache 概念
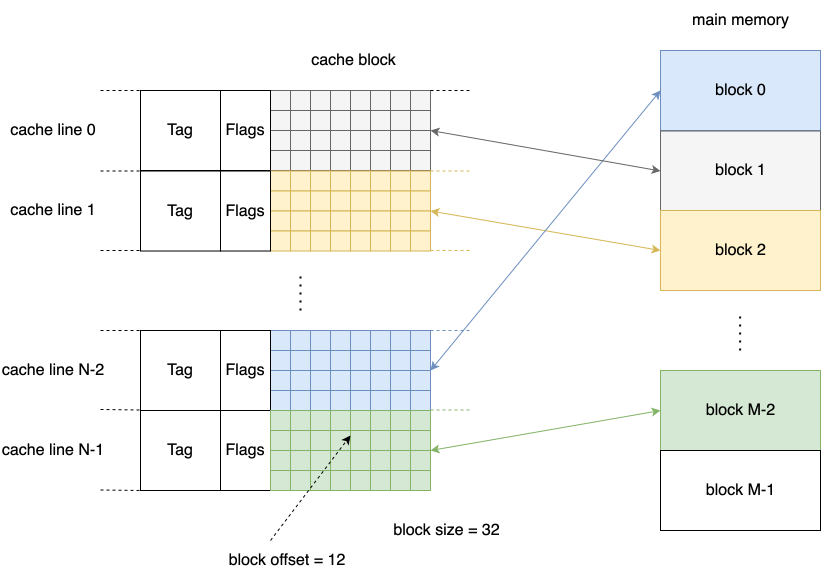
- cache 行(cache line):cache 行 中包含 各种标记字段(flag)和 数据(cache 块)
- 缓存块(cache 块):cache 中的一块存储空间,是与 主存 进行数据交换的基本单元
- 主存块:主存 中的一块存储空间,主存块 的大小一般与 cache 块 一致
- 块内偏移:某一个地址在块内的偏移,找到对应的块后,通过块内偏移找到该地址的具体位置
- 块大小:用于判断块内偏移位数。例如 ,所以 1 KiB 的块对应 10 位块内偏移。
缓存块
Cache block(缓存块),是计算机系统中用于存储的最小数据单元,它是 缓存 中的一个固定大小的数据块。每个 缓存块 包含一定数量的字节或字(通常是 2 的幂次方个字节),并用于存储从 主存(或更低级别的 缓存)中加载的数据。
cache block 的目的是为了方便对于 主存(main memory)数据的 缓存,主存块 的大小与 缓存块 大小一致,这样就可以将 缓存块 和 主存块 对应起来。
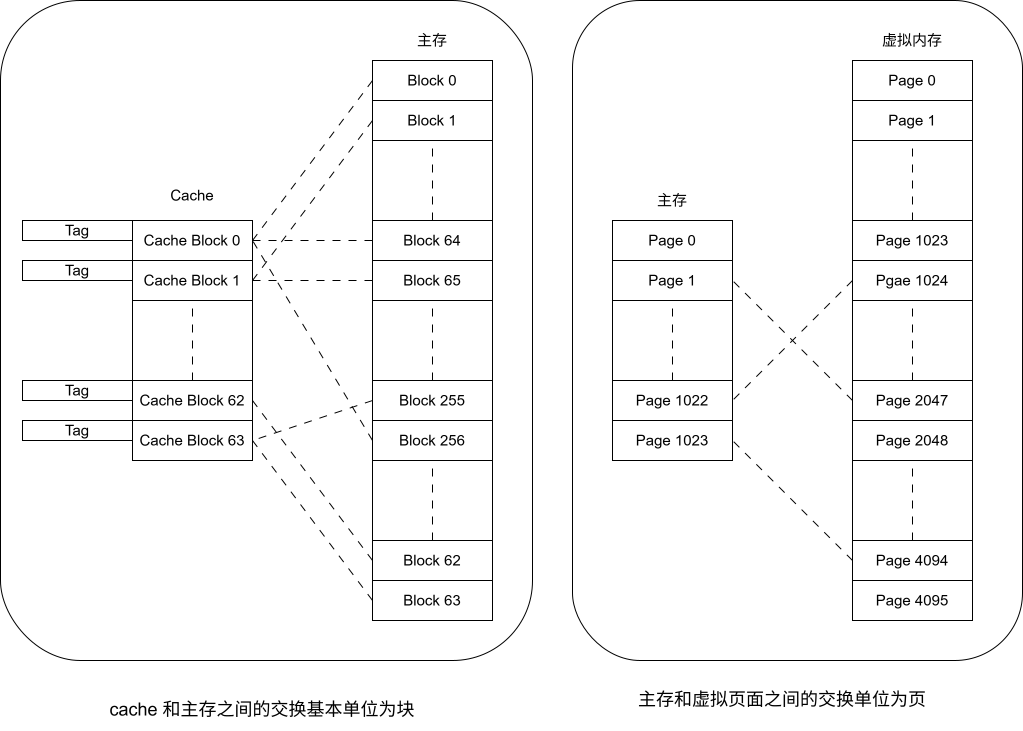
cache 中的存储空间可以被分为若干个 cache 块,主存 也可以被分为若干个 主存块,主存 和 cache 间的数据置换是以 块 为基本单位的。 这可以和页式内存进行类比,虚拟内存和物理内存都被分为若干个页面,物理内存空间的置换以 页面 为基本单位。
缓存块的大小
Cache block 的大小在不同计算机体系结构中可以有所不同,通常以字节(bytes)或字(words)为单位来表示。典型的 缓存块 大小可以是 32 字节、64 字节、128 字节等。较大的 缓存块 可以容纳更多的数据,提高了数据的局部性,但在某些情况下,较小的 缓存块 可能更适合,特别是对于小规模的数据访问。
Cache 和主存映射方式
Cache 的容量远小于主存,而主存中的任意一个数据块在程序运行过程中,都有可能被调入 Cache。 因此,体系结构必须回答一个核心问题:
当某个主存块需要进入 Cache 时,它可以(或应该)放到 Cache 的哪个位置?
这个从 主存块 → Cache 块 的对应规则,就称为 映射方式(Mapping)。
从抽象角度看,映射本质上定义了三件事:
- 可放置性: 一个主存块,允许放入 Cache 的哪些位置?
- 唯一性或灵活性: 是只能放到一个固定位置,还是可以放到多个位置,甚至任意位置?
- 硬件代价与性能权衡: 放得越自由,命中率越高,但查找与比较逻辑越复杂; 放得越受限,硬件越简单,但冲突失效(conflict miss)越频繁。
不同的映射方式,本质上就是在 命中率、访问速度、硬件复杂度 三者之间做不同取舍。
按照“一个主存块能映射到多少个 Cache 块”这一自由度的不同,常见的映射方式可以分为:
- 直接映射(Direct Mapped):只能映射到 唯一一个 Cache 块
- 全相联映射(Fully Associative):可以映射到 任意一个 Cache 块
- 组相联映射(Set Associative):只能映射到 某一组中的任意一个 Cache 块
下面我们从最简单、硬件代价最低的直接映射开始分析。
直接映射

在 直接映射(direct mapped)Cache 中,每个 主存块 只能映射到唯一一个特定 Cache 行。
主存块号 k 映射到缓存块号的计算公式为:
其中:
- k 为主存块号(从 0 开始编号),
- M 为缓存中的总块数。
直接映射示例
假设我们有一个 256KB 的缓存,其中每个缓存块是 64B,对于直接映射的 cache:
- 缓存 被分为
256KB / 64B = 4096个 缓存块。 - 内存 中的数据可以直接映射到这 4096 个位置中的其中一个,比如第 10000 个 主存块 映射到
10000 % 4096 = 1808个 缓存块。 - 当一个新的数据块需要被加载时,它会替换掉当前映射到该位置的数据块,不管缓存的其他位置是否为空。
全相联映射

在 全相联缓存(full associative)中,主存 中的任何块可以映射到缓存中的 任意缓存块。
其映射关系可表示为:
其中 C 为缓存总行数。
由于放置位置不唯一,硬件通常并行比较候选 Cache 行的 tag 来判断是否命中,而不是按软件方式逐行遍历。
如果 cache 的所有行都是满的,新的数据会根据某种 替换策略 来替换 cache 中的某一个 cache 块。
全相联映射示例
假设我们有一个 256KB 的缓存,其中每个缓存块是 64B,对于全相联映射的 cache:
- 缓存被分为
256KB / 64B = 4096个 缓存块。 - 全相联缓存中的每个主存块可以放置在任何缓存块中,即第
0到第4095个缓存块都可以存储该主存块。 - 当缓存满时,基于某种 替换策略 替换掉
4096个 缓存块 中的某一个。
组相联映射

组相联缓存(set associative 或 group associative)是 直接映射缓存 和 全相联缓存 之间的一种 折中方案。它将缓存块分为多个 组,每个组包含多个缓存块。主存块可以 映射到组中的任意一个缓存块。
当我们说一个缓存是 N 路组相连 的,意味着缓存被分为多个 组,每个 组 有 N 个 缓存块(N 路)。这样,当一个内存地址被映射到一个特定的组时,它可以放在该 组的任何一个缓冲块(一路)上。
如果一个组是满的,新的数据会根据某种 替换策略 来替换组中的一个 缓存块。
注意:N 路组相联表示一个组中有 N 个 Cache 行,而不是 Cache 中一共有 N 个组。
组相联映射中,主存块地址到缓存组索引的计算公式为:
其中:
- 缓存总块数 = 组数 × 路数
- N 表示 N 路组相联
组相联映射示例
假设我们有一个 256KB 的 缓存,其中每个 缓存块 是 64B,我们希望有 4 路组相联的组织。
- 这意味着 缓存 被分为
256KB / 64B = 4096个 缓存块。 - 因为是 4 路组相联,所以这些块被进一步组织为
4096 / 4 = 1024个 组。 - 每个 组 包含 4 个位置(即 4 路),任何内存地址映射到这个 组 的时候,可以放在这四个位置中的任何一个。
- 比如第 10000 个 主存块 位于第
10000 % 1024 = 784个 组,可能对应组内的任何一个 缓存块。
主存块 10000 如何定位并查询 Cache
依次比较直接映射与四路组相联的定位结果,并沿一次未命中路径观察标记比较、替换和填充。
确定 Cache 规模256KB÷64B=4096 行。当前只确定 Cache 行数,任何有效位、标记和数据均未改变。
硬件结构
下图展示的是一个 二路组相联 Cache 的结构示意图。
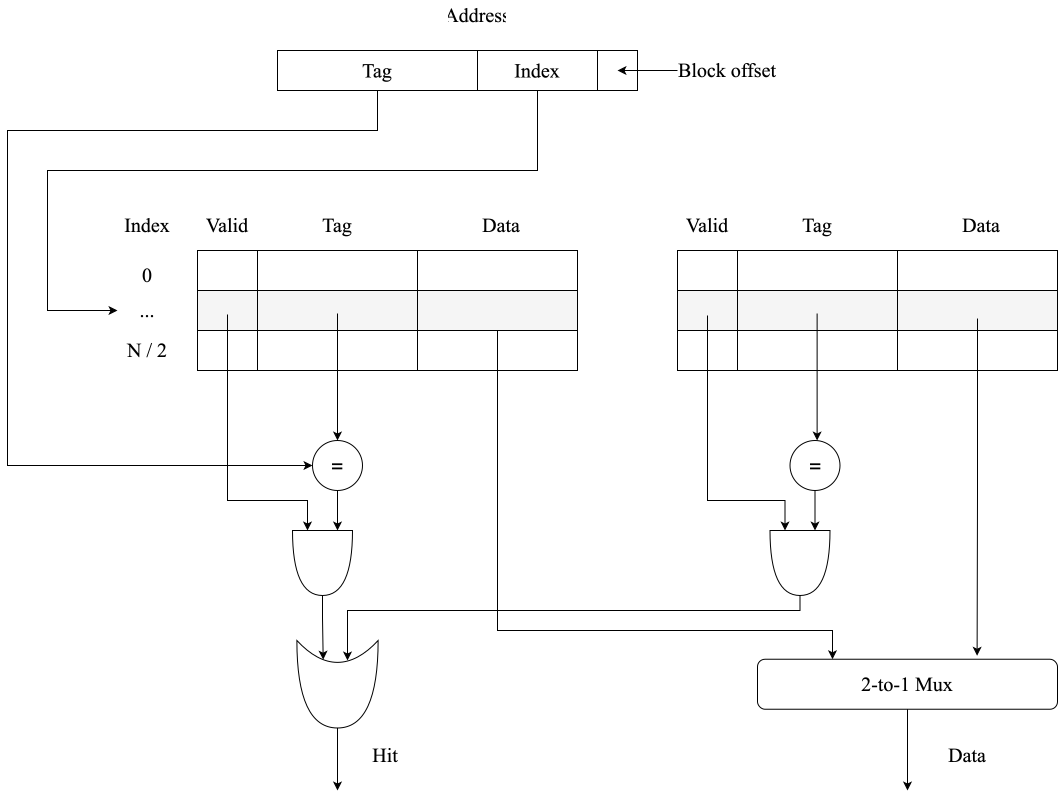
访问时,物理地址中的 组号(index) 用于定位到 Cache 中的某一 组。该 组 包含两个 Cache 块,每个块有 valid 位 和 tag 字段。
地址中的 tag 会同时送入两个 比较器,分别与组内两个块的 tag 进行匹配,并结合 valid 位 判断是否命中。
如果命中,选择器(multiplexer)根据比较结果,从两个块中选出正确的数据输出给处理器。若都未命中,则访问 主存。
比较器与选择器的作用
- 比较器(Comparator):用于判断 Cache 块 中的 tag 是否与当前地址匹配,决定是否命中;
- 选择器(Multiplexer):在多个块中有可能命中的情况下,负责根据比较结果选出正确的数据路径。
其他映射方式中的比较器与选择器
全相联 Cache
- 没有 index 字段,所有 Cache 行 都可能是目标;
- 地址的 tag 需要与 每一行 进行比较 ⇒ 需要 一个比较器对应一行;
- 最终由 多输入选择器 从所有行中选出命中的那一行。
➡️ 优点:命中率高 ➡️ 缺点:比较器数量多,硬件复杂,延迟高
直接映射 Cache
- index 字段直接决定数据应该位于哪一行;
- 只需比较该行的 tag ⇒ 仅需一个比较器;
- 无需选择器,命中即用,否则直接访问 主存。
➡️ 优点:硬件简单,速度快 ➡️ 缺点:容易发生冲突,命中率低
| 映射方式 | 比较器个数 | 是否需要选择器 | 硬件复杂度 | 冲突失效倾向 |
|---|---|---|---|---|
| 直接映射 | 1 | 否 | 低 | 高 |
| 组相联(N 路) | N | 是 | 中 | 中 |
| 全相联 | Cache 行数 | 是 | 高 | 无冲突失效 |
映射方式对比
假设 cache 有 M 个 cache 块,对于块号为 k 的 主存块:
- 直接映射:被映射到块号
k % M的 cache 块 - 全相连映射:可能被映射到任意一个 cache 块
- 组相连映射:对于 m 路组相连,被映射到组号为
k % (M / m)的 cache 组 中的任意一个 cache 块

| 特点 | 直接映射 | 全相联映射 | 组相联映射 |
|---|---|---|---|
| 主存块可放置位置 | 唯一一行 | 任意一行 | 固定组内任意一路 |
| 硬件复杂度 | 低 | 高 | 介于两者之间 |
| tag 比较范围 | 一行 | 全部行 | 一组内各路 |
| 冲突失效 | 多 | 无 | 较少 |
关联度
Cache 关联度(associativity)描述的是一块 主存地址 可以被映射到 缓存 中多少个不同的位置(cache lines)。
根据上面提及的 映射方式对比 可知关联度对比:
关联度排序
全相联 > 组相联 > 直接映射
在容量、块大小和访问模式相同的前提下,更高的关联度通常能减少 冲突失效,从而有机会提高 命中率;它并不保证对每一种工作负载都严格更高。另一方面,比较器、选择器和替换状态的硬件开销会增加,访问延迟和能耗也可能上升,所以关联度选择仍需权衡性能与成本。
Cache 地址结构
当给定一个 物理地址 时,Cache 的访问过程可以抽象为三个连续的问题:
- 这个地址属于主存中的哪一个块?
- 这个主存块在 Cache 中可能出现在哪些位置?
- 这些位置中是否真的缓存了该主存块?
逻辑划分
因此,从 “硬件判定流程” 的角度,物理地址在逻辑上可划分为以下三部分:
块内地址
- 作用: 确定访问数据在一个 主存块 / cache 块 内的具体偏移
- 位数:若块大小为 字节且按字节寻址,则为 位。
- 说明: 这一部分 只用于块内寻址,与映射方式无关
Cache 块匹配字段
- 作用: 用于 缩小搜索范围,确定该主存块可能被缓存在哪些 cache 块中
- 含义因映射方式而异:
直接映射
- 字段含义:Cache 块号(Cache Block Index)
- 作用: 一个主存块 只能映射到唯一的一个 cache 块
- 位数:。
全相联映射
- 字段含义:无
- 作用: 一个主存块 可能被缓存到任意一个 cache 块
- 位数: 0
- 说明: 必须 并行比较所有 cache 块的 tag
组相联映射
- 字段含义:组号(Set Index)
- 作用: 一个主存块 只能映射到某一组内的若干 cache 块
- 位数:。
总结一下三种映射方式的块匹配字段的计算方法:
标记
- 作用: 在已确定的候选 cache 块(或某一组)中, 通过比较 tag 判断是否真正命中
- 位数:
物理地址对应
具体而言,给定一个物理地址,访问 Cache 时的各个字段的对应方式如下图所示:
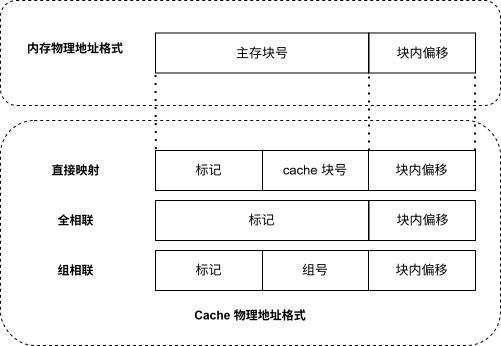
其中 块内偏移、cache 块号(直接映射)、cache 组号(组相联映射)的位数可以直接根据 cache 的参数计算出来,Tag 字段的位数需要通过物理地址的位数减去其他字段的位数来得到。
Cache 存储结构
cache 存储的内容大体上来说可以分为 数据 和 元数据 这两个部分:
- 数据部分:即 cache 块(cache block),缓存了某个主存块的内容
- 元数据部分:对 cache 访问的过程进行控制
cache 的存储结构可以理解为一张表:
其中字段的含义与 页表 近似,下面列出了:
- 有效位(valid):
- 该 cache 行 是否存储有缓存数据,位数为 1 位。
- 标记(tag):
- 根据物理地址中的 tag 字段与该字段匹配,以判断是否命中,位数按照 cache 地址结构 进行计算。
- 脏位(dirty):
- 访问位(reference):
- 用于记录访问信息,服务于 块替换算法,其位数取决于替换算法。
- LRU 状态的具体编码由实现和题目决定;若用“每路的最近使用次序”编码,单路序号至少需要 位,但完整 LRU 元数据不一定只是每路一个序号。
- 数据块(block):
- 缓存的数据块,为 主存块 的一个副本。
注意:Cache 的存储结构依题目而定。有些题目不计脏位或替换状态;计算总容量时必须按题意确认是否包含有效位、Tag 与其他元数据。
Cache 中的块替换
块替换算法适用于 全相联映射 和 组相联映射,因为在这两种组织方式中,同一主存块可能被 多个 cache 块 中的任意一个所缓存;因此当需要把新块写入时必须决定把哪一个已有的 cache 块淘汰。而在 直接映射方式 中,主存块只能对应唯一的 一个 cache 块,如果发生冲突,直接用新块覆盖该 cache 块即可,无需额外的替换算法。
替换过程
命中判定与替换步骤
- 确定候选集合 根据地址映射方式,确定对应的 cache 组(组相联)或整个 cache(全相联)作为候选块集合。
- 命中判定 在候选块中:
- 仅对 valid=1 的块进行 tag 比较;
- 若存在某块
valid=1 且 tag 匹配,则发生 cache 命中,访问结束。
- 缺失处理(cache miss) 若未发生命中:
- 若候选块中存在
valid=0的块,则选择其中一个空闲块,将主存块加载到该块中,并设置valid=1、更新 tag; - 若所有候选块均为
valid=1,则根据 块替换算法(如 LRU、FIFO、随机等)选择一个块进行淘汰,并写入新主存块。
- 若候选块中存在
替换算法
当 CPU 访问某个物理地址而在 cache 中未命中时,需要把该地址所在的 主存块 调入 cache。如果该 主存块 映射到的 cache 块(即同一路径或同一个集合)已经全部占满,就必须在这些已占用的 cache 块 中挑选一个进行替换。常用的替换策略有 FIFO(先进先出)、LRU(最近最少使用)和 LFU(最不经常使用)等。
这套思路与操作系统中的页面置换算法本质相同,详情请参见 页面置换算法。
Cache 写策略
因为 cache 实际上存储的是主存的一个小副本,所以对于写操作,就需要考虑两者间的数据一致性的问题。
cache 的写策略代表当我们对某个物理地址上的数据进行写入时,应该如何写入对应的存储单元,以及如何协调 cache 和 主存之间的 数据一致性,写策略按照地址查询是否命中 cache 可以分为四种方式。
命中时
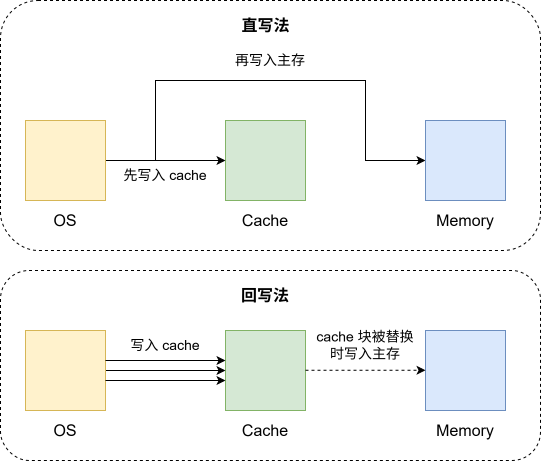
如果某次地址查询命中 cache,可以使用如下策略:
- 直写法(Write Through):
- 每次写操作都会同时更新缓存和主存。
- 从体系结构可见结果看,每次写都要把更新传向下一层;实现可以使用 写缓冲 暂存这些写请求,因此 CPU 不一定等待每一次主存写完成,但缓冲区满时仍会形成停顿。
- 回写法(Write Back):
- 当数据被修改时,它首先被缓存在 cache 中,脏块通常在被替换时才写回对应的主存块;显式刷新、DMA/一致性协议等情形也可能要求提前写回。
- 这种写策略是异步的,并不是写入 cache 后立马就要写入主存,可以多次写入 cache 后在另一个时刻再将cache 块写入主存。
注意:使用回写法时需要设置脏位。脏位记录 Cache 块是否被修改;只有脏块被替换时才需要写回主存。
可以看到,这种策略将多次 cache 写入合并为一个主存写入,对于写操作比较频繁的场景,其实很大幅度地提升了效率。
未命中时
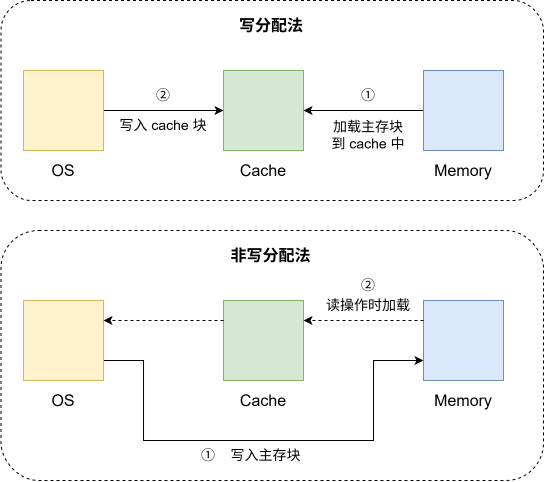
如果 没有命中 cache,也有如下策略:
- 写分配法(Write Allocate):
- 物理地址对应主存块被 加载 到 cache 块中(先执行一次对应主存块的读操作),然后更新 cache 块
- 非写分配法(No-Write Allocate):
- 不加载 主存块至 cache 中,直接更新主存块,只有当执行读操作时才将主存块加载进入 cache 块
策略的组合
命中 和 未命中 的方法常常通过如下方式一起使用:
- 直写法(write-through)和 非写分配法(not-write-allocate)通常会一起使用,适用于那些写操作不频繁或者写操作不太可能访问同一数据的情况。
- 回写法(write-back)和 写分配法(write-allocate)通常会一起使用,适用于那些写操作频繁的情况。
提示:方法的组合方式很容易被混淆,可以通过数据主要写向哪一层来记忆:
- 直写法 和 非写分配法 都倾向于 主存 操作(写入 主存)。
- 回写法 和 写分配法 都倾向于 cache 操作(写入 cache)。
地址字段推导、未命中分类与性能判断
设物理地址长度为 位,一个 Cache 块大小为 字节,Cache 共有 个块,每组 路,则组数为 。地址从低到高可拆为
先把地址除以块大小得到主存块号 。直接映射时行号为 、标记为 ; 路组相联时组号为 、标记为 。全相联没有组号,所有块都可比较标记。这样推导比死记“某几位叫 index”更稳,因为块大小、组数和相联度变动后只需重新计算 。
一次读命中必须同时满足:目标组中存在有效位为 1 的行,其标记与地址标记相同,然后再用块内偏移取出字节或字。数据位为全 0 并不表示未命中;是否有效由有效位和标记决定。若同一组有多路都不匹配,才选择空行或按替换策略逐出一行;被逐出行若采用回写法且脏位为 1,还必须先写回主存。
三类未命中与平均访问时间
冷启动时首次访问某块造成的是强制未命中;工作集超过 Cache 容量时可能出现容量未命中;不同主存块映射到同一行或同一组、即使 Cache 其他位置仍空闲也互相挤出时是冲突未命中。提高相联度主要缓解冲突未命中,增大总容量主要缓解容量未命中,预取或更大块有时能利用空间局部性,却也可能因占用更多容量和带来无用数据而适得其反。
在“先查 Cache,未命中再访问下一级”的串行简化模型中,平均访问时间可写为
其中未命中代价 包含补入整块、必要的写回以及等待下一级的时间。题目若给出并行 TLB/Cache 查询、多级 Cache 或写缓冲,则应按实际时序重列时间,不能把所有命中时间和未命中时间无条件相加。
块大小、相联度与容量的三角取舍
块较大可以一次带入相邻数据,可能降低强制未命中;但在总容量固定时,块数会变少,较大的无用数据也会占据带宽和 Cache 空间,反而增加容量或冲突问题。相联度提高后,同一组可容纳更多相互冲突的主存块,通常减少冲突未命中,却需要更多标记比较器和选择逻辑,命中时间、能耗或实现复杂度可能上升。
计算容量时要分清“数据区容量”和“实现总容量”。若 Cache 有 个数据块、每块 字节,数据区为 字节;实际芯片还要为每行存储标记、有效位、脏位以及替换状态。题目问 Cache 容量时若未特别说明,常指数据区;题目给出地址字段并让计算位数时,则必须把控制位一起纳入。
替换策略只在组内没有空闲块且发生未命中时才需要。直接映射每组只有一行,无选择余地;全相联与组相联才会讨论 FIFO、LRU、随机等。写回策略下,脏位从“写入 Cache 后尚未同步主存”变为“逐出时需写回”的判断依据;写直达虽每次写都更新下一级,却常借助写缓冲避免让 CPU 为慢速主存长期停顿。